预计阅读时间:13 分钟
nvidia TAO Toolkit 使用总结
TAO 表示 train、adapt、optimize。TAO Toolkit 是 nvidia TAO 框架的低代码版本,主打使用者无需专业 AI 知识即可构建高准确度模型,在英伟达设备上做到训练部署一条龙。低代码不等于无坑,本文按流程走一遍,把每一步的暗雷标出来。
流程参考快速上手 tao toolkit。
环境准备
1. 注册与登录 ngc
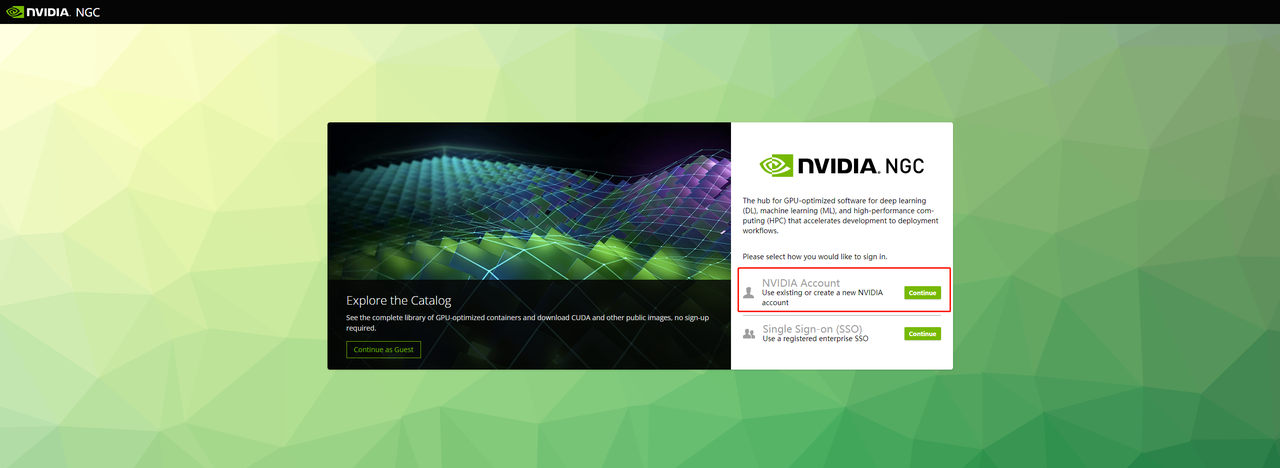
注册英伟达开发者账号(略),去 ngc 官网目录右上角用英伟达账号登录。
2. 生成 API Key
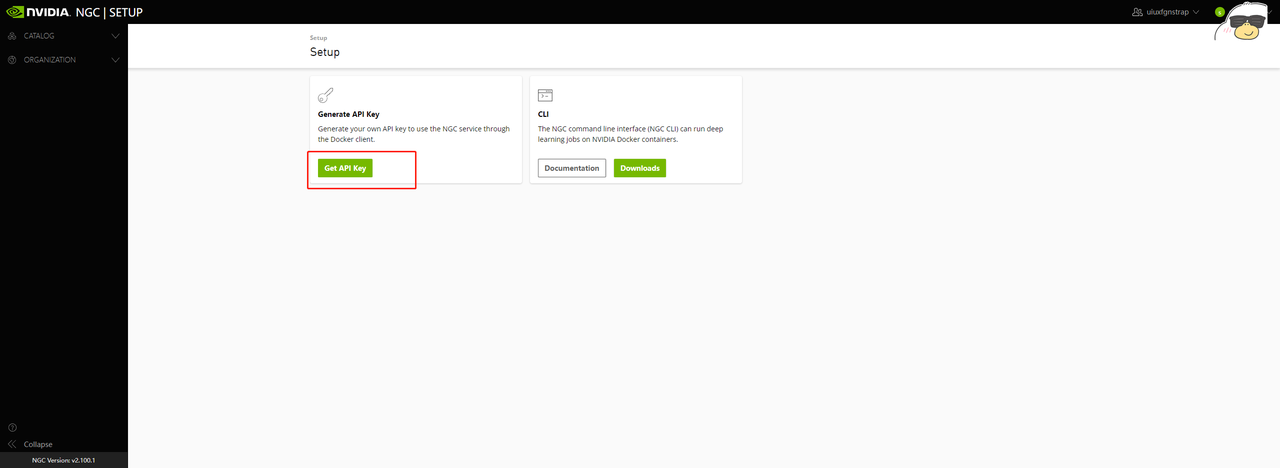
回到 ngc 首页,右上角点自己的账号,进 Setup,出现 Generate API Key 选项卡,点 Get API Key 进入。
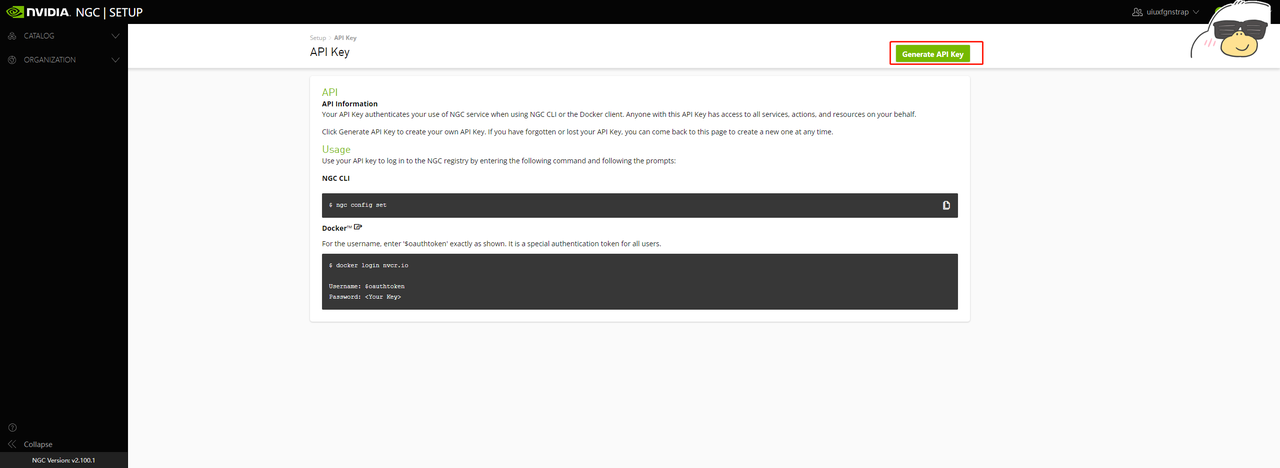
点击 Generate API Key,下方生成专属 Key。这个 Key 必须记下来,以后都用它登录;忘了只能重新生成,且新 Key 一生成旧 Key 自动作废。下图仅作示例、没有实际点击。
3. docker 登录 nvcr.io
回到要部署 TAO 的机器。这里需要支持 gpu 的 docker 和一定版本的显卡驱动(太旧不行),具体版本参考安装需要的软件版本。新版 docker 已原生支持 gpu,不用特意装 nvidia-docker;docker 有问题就升级 docker,显卡驱动更新略。
docker login nvcr.io
用户名是 $oauthtoken,密码是上一步生成的 Key,成功会显示 "Login Succeeded"。
4. 安装 ngc cli
回到 ngc 官网的 Setup 界面安装 ngc cli 工具。这个工具不单独装也可以——TAO 示例工程里带了安装步骤,但可能引入额外的问题,所以这里选择手动安装。工具说明见 ngc-cli 工具介绍:
The NGC CLIs are command-line interfaces for managing content within the NGC Registry. The CLI operates within a shell and lets you use scripts to automate commands. With the NGC Registry CLI you can view a list of GPU-accelerated Docker containers, deep-learning models and resources, download and upload them, and manage users and teams (for NGC Private Registry administrators).
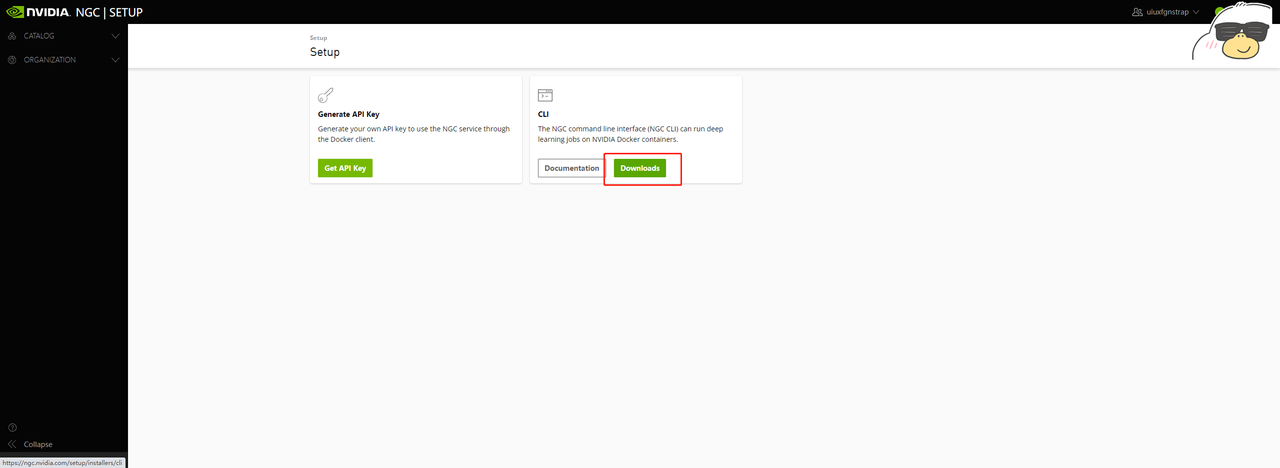
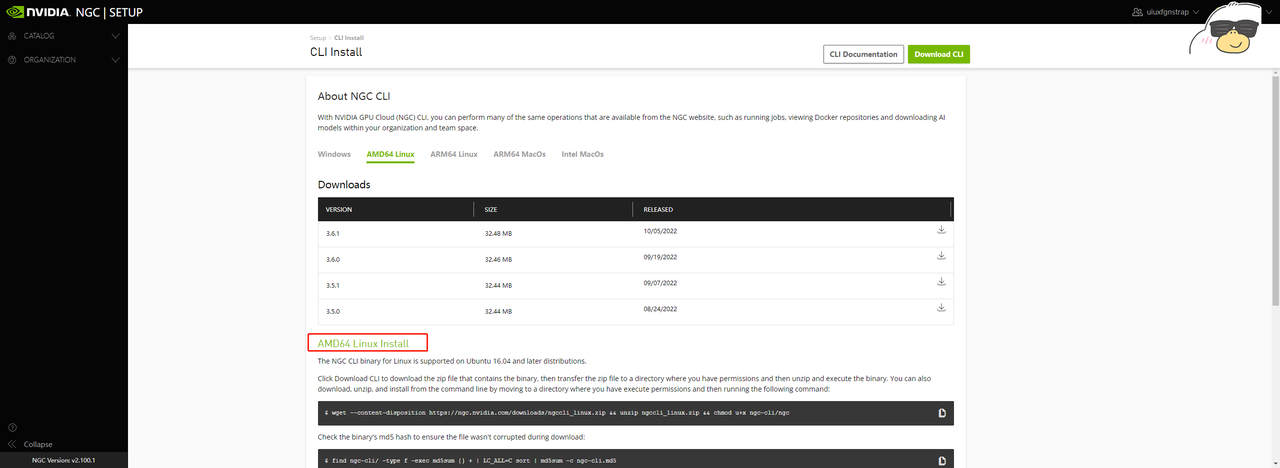
官网提供不同平台的下载,linux 直接命令行安装:
# 下载
wget --content-disposition https://ngc.nvidia.com/downloads/ngccli_linux.zip && unzip ngccli_linux.zip && chmod u+x ngc-cli/ngc
# 验证下载文件完整性
find ngc-cli/ -type f -exec md5sum {} + | LC_ALL=C sort | md5sum -c ngc-cli.md5
# 配置到环境变量 .bashrc
export PATH=$PATH:到ngccli的路径/ngc-cli
# 设置ngc配置文件
ngc config set
配置文件要填上面生成的 API Key,其他默认即可;后续想改随时去 /home/user/.ngc/config(user 替换成当前用户)。
5. 虚拟环境与工具
本地创建 TAO 运行的虚拟环境,此处用 conda:
conda create -n launcher python=3.6
conda activate launcher
安装 Jupyter 和 Tensorboard:
pip install jupyter
pip install tensorboard
6. 下载示例工程
wget --content-disposition https://api.ngc.nvidia.com/v2/resources/nvidia/tao/cv_samples/versions/v1.4.0/zip -O cv_samples_v1.4.0.zip
unzip -u cv_samples_v1.4.0.zip  -d ./cv_samples_v1.4.0 && rm -rf cv_samples_v1.4.0.zip && cd ./cv_samples_v1.4.0
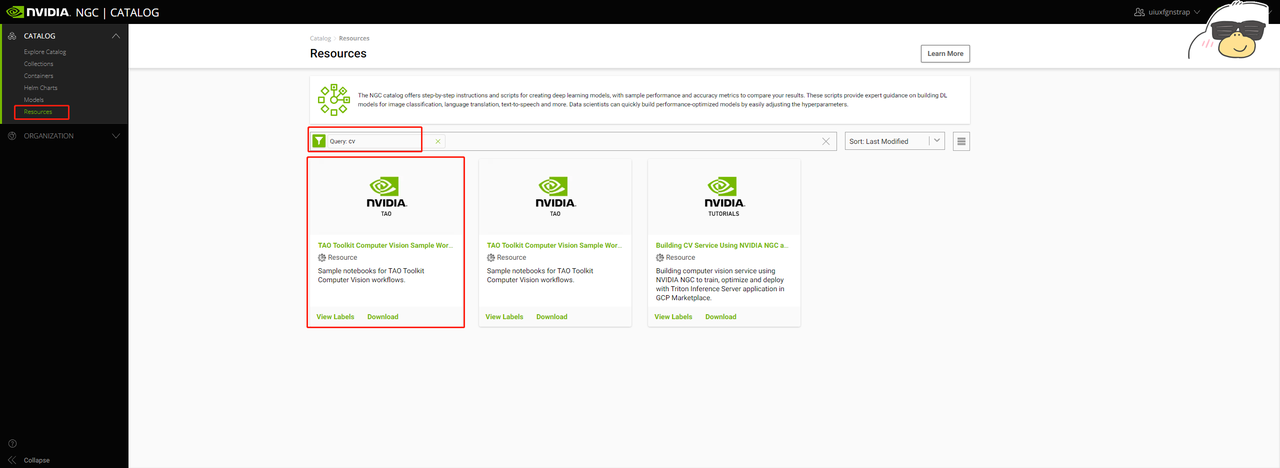
这里下载的是 v1.4.0,英伟达会持续更新版本。需要其他版本去 tao toolkit cv samples 版本信息查看,或在 ngc 首页左侧目录选 Resources,搜索框搜 cv,找 TAO Toolkit Computer Vision Sample Workflows:
7. 启动 jupyter notebook
进入示例工程目录并激活虚拟环境,运行 jupyter notebook。可选择后台运行,防止远程掉线或误关终端:
nohup jupyter notebook --ip 0.0.0.0 --port 8888 --allow-root >/dev/null 2>&1 &
至此可以通过网页远程操作训练服务器。
训练
8. 路径映射与模型 KEY
TAO 实际的训练不在训练机本地,而是跑在 docker 容器里,训练细节不需要我们关心;但训练数据和配置文件在本地,所以要配置本地路径到容器内路径的映射。示例工程已经把映射配好了,只要在工程开头找到路径配置的位置改成自己的。以 bpnet 为例:
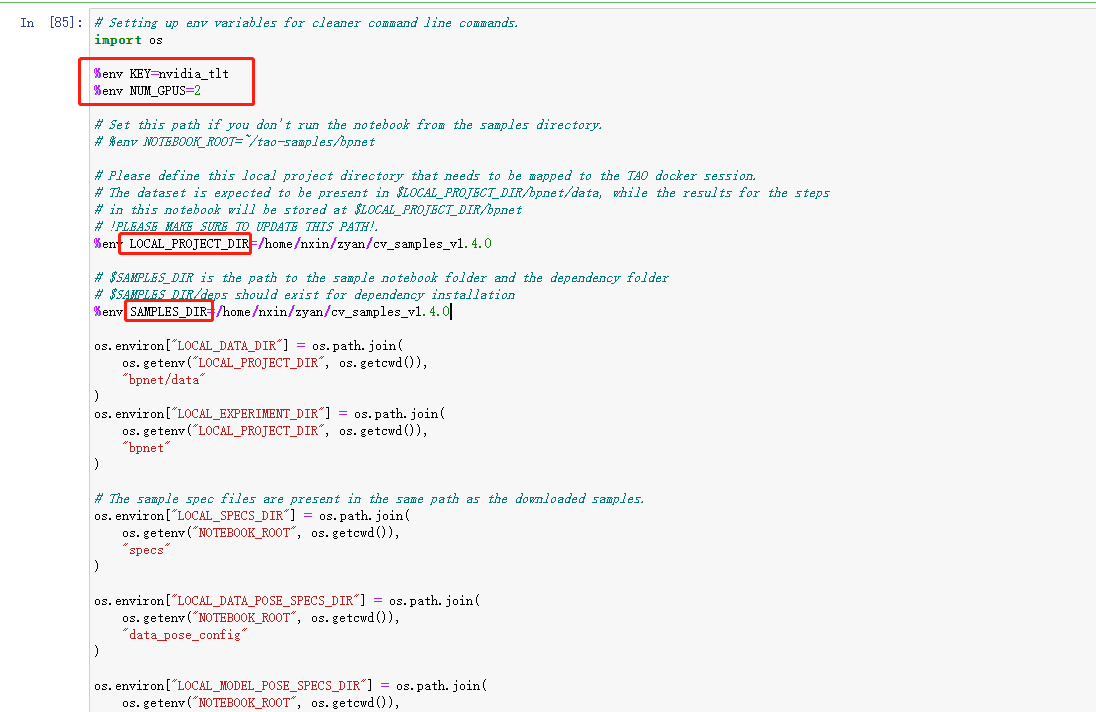
模型的 KEY 已经预填,建议改成自己的密码对模型加密,并且必须记住:后续对模型的一切操作(包括部署)都需要这个 key,没有 key 无法对 TAO 模型做任何操作;只有部署后转成 TensorRT 形式的模型才不受 key 限制。
还要改三处:工程用到的 gpu 数量、本地 bpnet 工程路径、本地示例工程路径。其余路径关系(含容器映射)都已配置好,顺着往下点即可。后面会出现本地路径和容器路径两种,只需要操作本地路径,容器路径用默认值——分不清也没事,都是配好的。不过数据下载会有网络问题,自己下载再放进去时要注意路径;模型导出同样有路径问题。
9. 安装 nvidia-tao 的版本选择
示例工程中有一步:
!pip3 install nvidia-tao
默认装最新版,但不同版本对应的 TensorRT 版本不同,对应关系见 tao toolkit 版本信息。TAO 版本与 triton 镜像版本是对应的:例如 3.0-22.05 的 TAO Toolkit 对应 nvcr.io/nvidia/tritonserver:22.05-py3,22.05 对 22.05、22.02 对 22.02。想让 TAO 转出的 tensorrt 模型能在 tritonserver:22.02 里跑,安装时就要指定 3.0-22.02(即便如此仍可能因显卡系列算力不同而无法运行,所以钉死版本不是唯一出路,「模型部署」一节会介绍其他方法)。
10. 训练流程
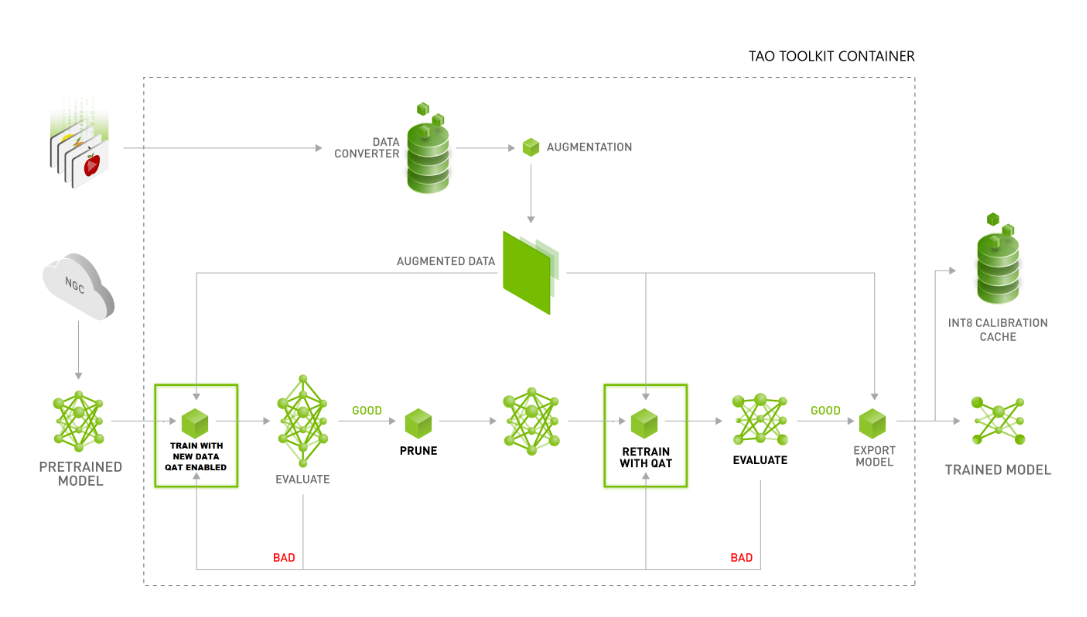
把数据和预训练模型传进容器 train;train 结束做评估,结果不好就加新数据再 train,达标则剪枝,得到剪枝过的模型再 retrain;retrain 结果好走部署流程,不好就重新 retrain。
注意:retrain 出来的模型不能再剪枝,只有 train 出来的模型才能剪枝。train 和 retrain 表示模型所处的不同阶段——train 的参数、剪枝的参数、retrain 的参数都可以调,但要让它们工作在各自的环节。不能把两者简单理解为「训练」和「再训练」,容易混淆:只要没剪枝,train 多少轮都还在 train 阶段,哪怕实际上已经反复训练多次。
部署
11. 模型导出与转换
如果直接在示例工程里导出 tensorrt 模型,tensorrt 版本取决于工程 python 环境装的 nvidia-tao 版本,算力取决于训练服务器的显卡——部署到其他机器或容器时,版本、算力不匹配的问题就来了。官方算力查询:英伟达产品算力查询。
正道是从示例工程导出 .etlt 模型用于部署。在部署服务器上有两条路:
路线一:像前面那样在部署机上再装一套 TAO,配好路径映射后,找到示例工程里的 tao converter 语句,把模型换成要部署的进行转换。好处是转出的 tensorrt 版本与训练环境一致,缺点是麻烦。
路线二:用 ngc cli 下载独立的 tao-converter 直接转:
# <latest_version> 换成要下载的版本号,/path/to/download/directory 指定下载地址
ngc registry resource download-version nvidia/tao/tao-converter:<latest_version> --dest /path/to/download/directory
sudo apt-get install libssl-dev
export TRT_LIB_PATH="/usr/lib/x86_64-linux-gnu"
export TRT_INC_PATH="/usr/include/x86_64-linux-gnu"
# 进入上面下载的tao-converter工具目录
# 加执行权限
chmod +x tao-converter
# 运行转换命令,同TAO中的命令
./tao-converter /home/nxin/zyan/peoplenet_model/resnet34_peoplenet_int8.etlt -k tlt_encode -t fp16 -e /home/nxin/zyan/peoplenet_model/resnet34_peoplenet_fp16.engine -p images,1x3x544x960,8x3x544x960,64x3x544x960 -d 3,544,960
tao-converter 的版本信息在 tao converter 版本信息查看,Overview 里有参数说明。这条路的坑:ngc 官网只提供有限几个版本的 tao-converter,对应的 TensorRT 版本就那几个,可能和训练服务器、triton 镜像的版本都不一致;triton 镜像对应的 TensorRT 版本查 triton 版本信息。
12. int8 模型与标定文件
TAO 提供模型量化,量化过程在 TensorRT 内部完成,不需要我们参与。我们要做的是选 10%-20% 的训练数据生成量化标定文件:示例工程运行中会生成形如 calibration.320.448.deploy.bin 的文件,ngc 官网下载的可部署模型里也会带 txt 形式的标定文件。部署 int8 tensorrt 模型必须有标定文件。文件内容大致如下:
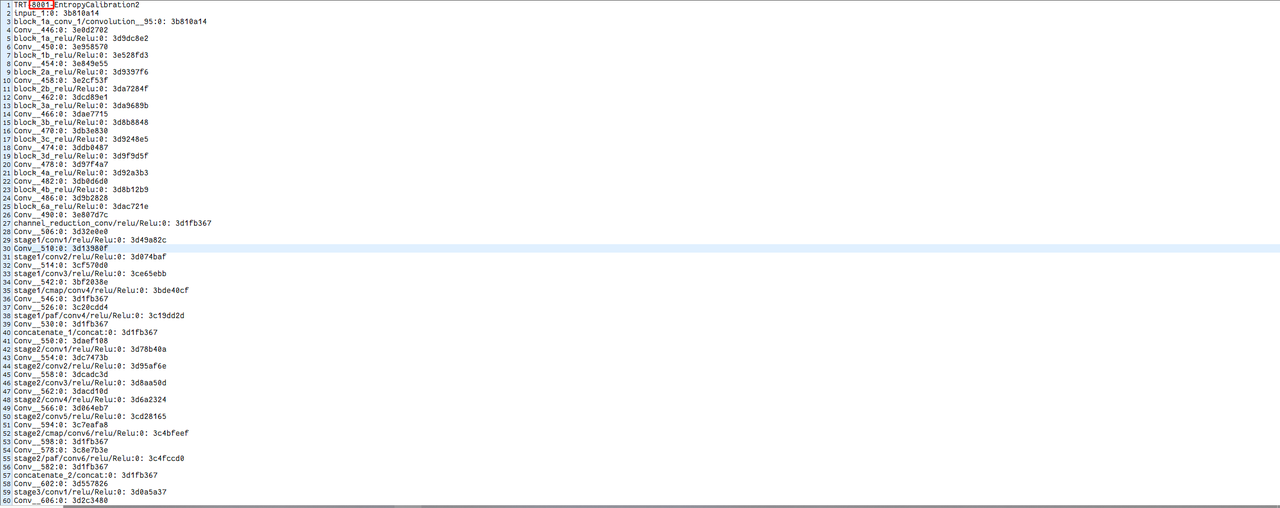
里面是网络每层的标定参数。注意开头会给出标定文件的 TensorRT 版本——由于量化由 TensorRT 完成,实验中发现 TensorRT 版本会影响标定文件:比如从官网下载老版本可部署模型,标定文件是老版 TensorRT 的,而部署时要转成新版 TensorRT 模型,用这个老标定文件会导致模型输出数据异常。标定文件的 TensorRT 版本必须和部署模型的 TensorRT 版本一致。
目前试出两种解法:
- fp16 部署,直接绕开标定文件;
- 用 TAO 对相应网络重新生成对应 TensorRT 版本的标定文件,此时要注意示例工程的 nvidia-tao 版本(决定 TensorRT)和标定数据的选取。
13. 可部署模型与可训练模型
TAO 提供两种模型:可训练模型,正常训练部署;可部署模型,模型里加了一些不可训练的后处理层,只用于部署、不可训练。export 步骤加 --sdk_compatible_model 参数即导出可部署模型。
这里有个问题:官方只说加了不可训练的后处理层,但具体处理了什么并没有讲;TAO 本身虽然提供推理功能,但部署层面不提供模型的前后处理文件。所以做部署必须自己搞懂模型的输入输出——ngc 官网 model 页会列出各 model 用到的论文,看不懂输出内容就得去啃论文。
英伟达 github 提供了一个 triton 部署仓库,包含分类、检测、分割等网络的前后处理,docker 部署:tao toolkit triton 部署官方仓库。但它也没覆盖所有网络,比如 2D 人体姿态(输出同 openpose)就没有,需要自己写。
两种模型都可以去官方模型提供地址搜对应网络获取。
14. 可视化训练过程
pip 安装 tensorboard,--logdir 指到训练文件夹或其下的 event 文件夹,网页查看:
nohup tensorboard --logdir=/home/nxin/zyan/cv_samples_v1.4.0/bpnet/models/exp_m1_retrain/ --host 0.0.0.0 --port 6006 >/dev/null 2>&1 &
未完待续,持续更新。
本文由 aboom 原创,转载请注明出处。