预计阅读时间:7 分钟
win10 python 环境安装 GPU 版本 opencv 并简单使用
pip 装的 opencv 是没有 CUDA 加速的,想在 Python 里用 GPU 版 opencv 只能自己从源码编译。本文记录 win10 下完整的编译安装流程,以及一组「GPU 未必比 CPU 快」的实测。
环境
- python:anaconda base 环境,3.9.7
- CMake:3.24.1(cmake 下载)
- opencv:4.6.0
- vs:2019 社区版
- CUDA Toolkit:11.3.1(cuda-toolkit 下载,
nvcc -V查看版本) - cuDNN:8.2.1(cuDNN 下载)
英伟达 cuda 相关下载需要注册英伟达账号,vs2019 和 anaconda 的安装略过。CUDA Toolkit 和 cuDNN 版本需要对应,cuda 11 系试了几个都没问题,更老的没验证;vs 版本老一些没关系。
下载源码
从仓库下载指定版本 opencv(需要安装 git,git 下载):
git clone -b 4.6.0 https://github.com/opencv/opencv.git
opencv-contrib 版本需要和 opencv 保持一致:
git clone -b 4.6.0 https://github.com/opencv/opencv_contrib.git
cmake-gui 配置与编译
1、打开 cmake-gui,指定 opencv 工程路径后点 Configure

2、选安装的 vs 版本,使用本机默认编译器。第二行空着的是生成选项:新版 cmake 默认 x64,64 位机器不用填;老版本 cmake 默认可能是 32 位,需要手动填 x64

3、第一次 Configure 结束会出来一大堆编译选项,中间遇到什么错误警告都不用管,反正后面还要再点

4、搜 JAVA,取消勾选 BUILD_JAVA

5、搜 TESTS,取消勾选 BUILD_TESTS

6、搜 VTK,取消勾选 WITH_VTK

7、搜 NONFREE,勾选 OPENCV_ENABLE_NONFREE

8、搜 PYTHON3,能勾选的全勾选。环境地址会默认给到 anaconda 的 base 环境,不用改,到时候用 base 环境即可

9、搜 CUDA,全部勾选

10、点击 Add Entry,增加 WITH_CUDNN 配置

11、搜 MODULES,OPENCV_EXTRA_MODULES_PATH 设置为 opencv_contrib 的 modules 文件夹路径

12、再次点击 Configure。警告不用管,一般会遇到很多下载失败,都是网络问题——我这边科学上网换几个节点接着点 Configure 就好了;没有条件的可以查一下怎么单独下载这些失败的文件,有点啰嗦这里不展开

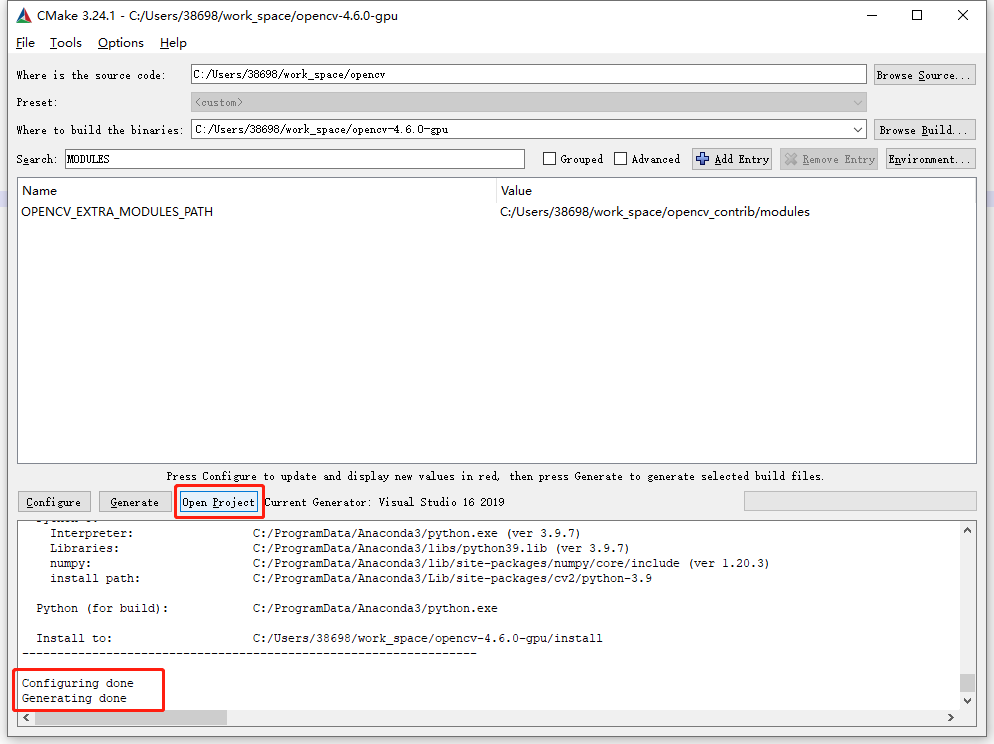
13、没有错误和失败(警告无所谓)之后,点击 Generate

14、生成结束用 vs 打开项目
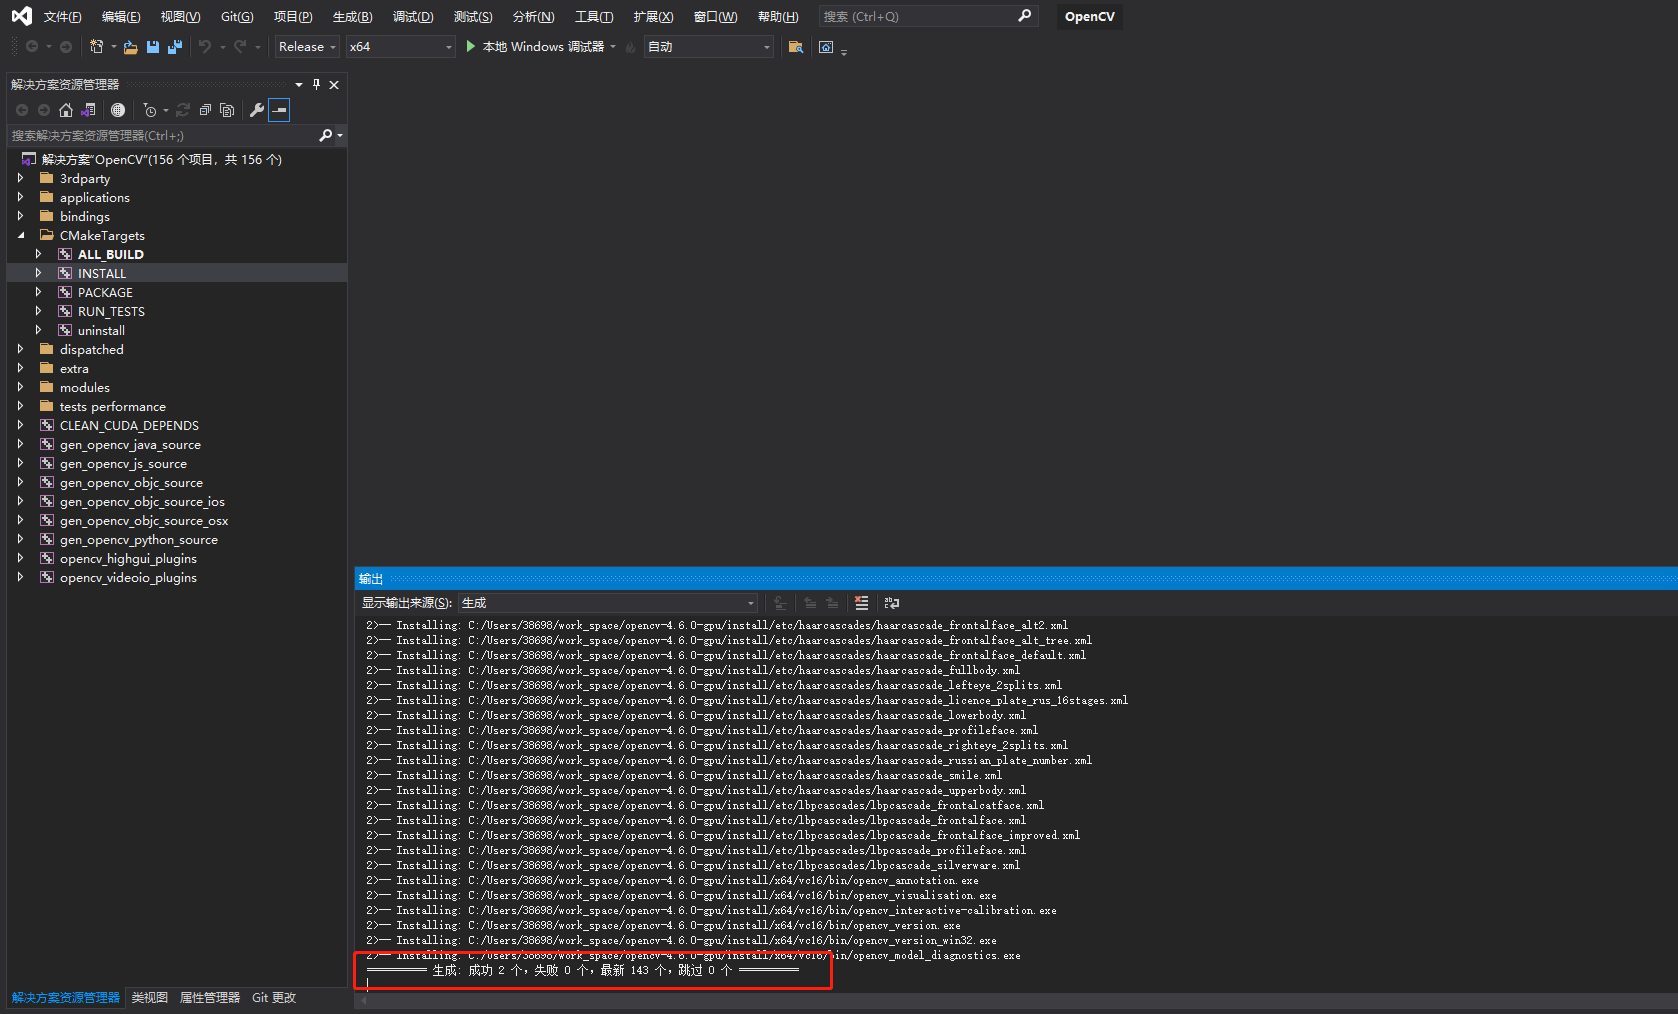
15、上方选到 Release x64,右键 ALL_BUILD,点击生成

16、安装成功
17、编译安装的 opencv 无法用 pip 或 conda 直接查看。打开 base 环境命令行验证,弹出版本号 4.6.0 即安装成功:
python -c "import cv2; print(f'OpenCV: {cv2.__version__}')"

18、查看本机是否有可用的 cuda 设备,输出大于等于 1 说明 gpu 可用:
import cv2


print(cv2.cuda.getCudaEnabledDeviceCount())
Python 调用 GPU 版 opencv 要用 cv2.cuda 下的方法。这部分没有对应的 python 源码,pycharm 无法跳转到方法定义,用法只能查对应版本的官方文档(opencv 4.6.0 cv2.cuda 包含的方法)。
简单使用
以我最近任务里的透视变换代码为例。CPU 版本:
result = cv2.warpPerspective(imageA, H, (imageA.shape[1] + imageB.shape[1], imageA.shape[0]))
result[0:imageB.shape[0], 0:imageB.shape[1]] = imageB
GPU 版本:
cuMatA = cv2.cuda_GpuMat()
cuMatA.upload(imageA)
result = np.zeros((imageA.shape[0], imageA.shape[1] + imageB.shape[1], 3), dtype=np.uint8)
cuMatr = cv2.cuda_GpuMat()
cuMatr.upload(result)
stream = cv2.cuda_Stream()
cv2.cuda.warpPerspective(src=cuMatA, dst=cuMatr, M=H, dsize=(imageA.shape[1] + imageB.shape[1], imageA.shape[0]), stream=stream)
result = cuMatr.download()
result[0:imageB.shape[0], 0:imageB.shape[1]] = imageB
对比可见 GPU 版的使用只多了三步:
- 声明 gpu 使用的矩阵
cv2.cuda_GpuMat(); - 把 cpu 上 ndarray 形式的矩阵转成 gpu 形式并上传,
cuMatA.upload(imageA); - gpu 形式的矩阵无法直接使用,需要把数据从 gpu 下载回 cpu,
cuMatr.download()。
stream 我理解是数据在 cuda 层面的异步:上面代码的上传、计算、下载是线性执行的,通过 stream 可以让它们异步进行,用于海量数据处理。stream 暂时没仔细研究,先 mark 一篇讲这个的文章:opencv 的 cuda stream 在 python 中的应用。
实测:GPU 不一定比 CPU 快
测一下项目中 gpu 透视变换和 cpu 透视变换的速度。
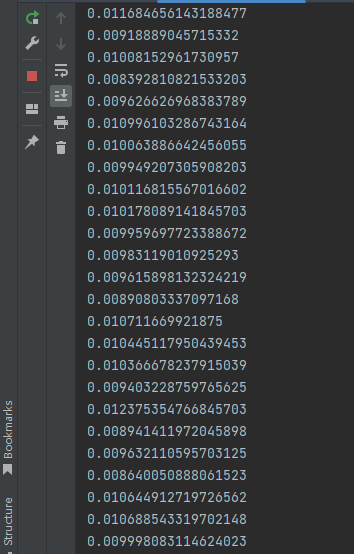
cpu 一帧耗时:
gpu 一帧耗时:
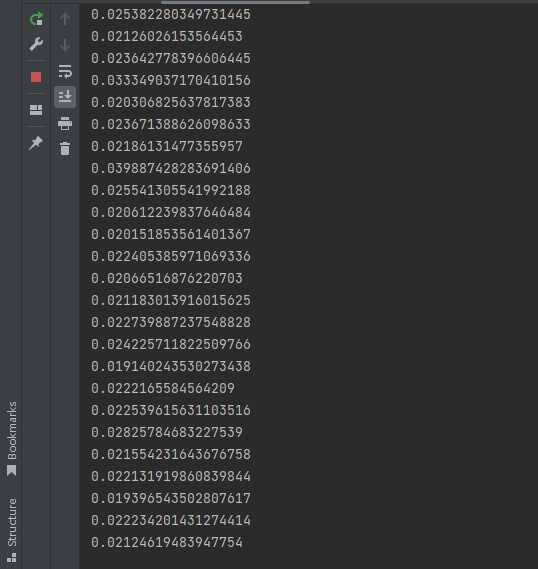
结果 cpu 差不多比 gpu 快一倍——数据的上传下载非常耗时,用 gpu 做矩阵运算并不一定比 cpu 快,所以项目暂时选择 cpu 版。
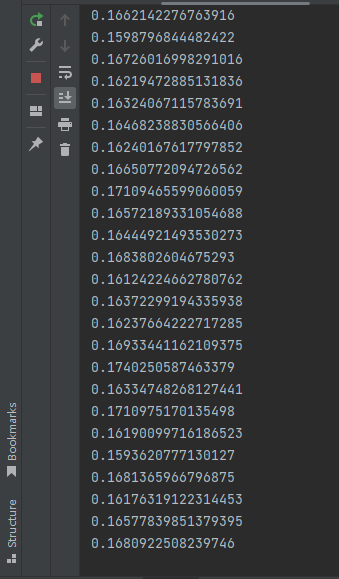
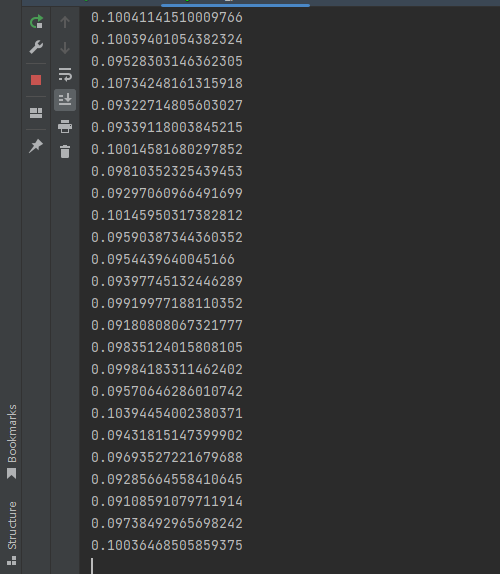
项目还用了鱼眼矫正。查文档发现 4.6.0 版本 cv2.cuda 下没有 fisheye 模块——难道 gpu 版 opencv 白折腾了?代码一行没改,直接测一下速度对比。
cpu 版本:
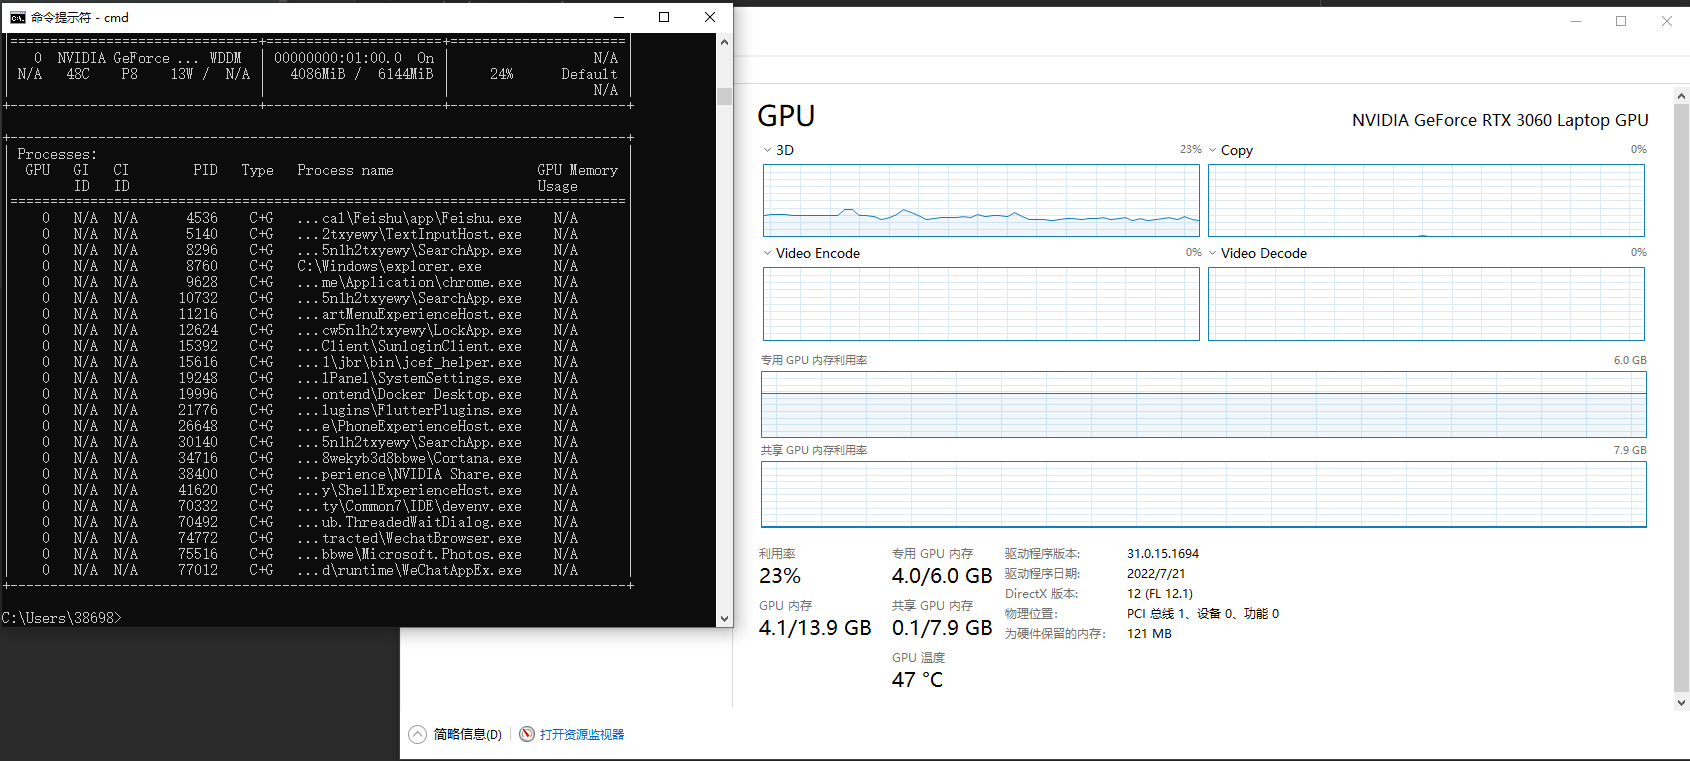
gpu 占用:
gpu 版本:
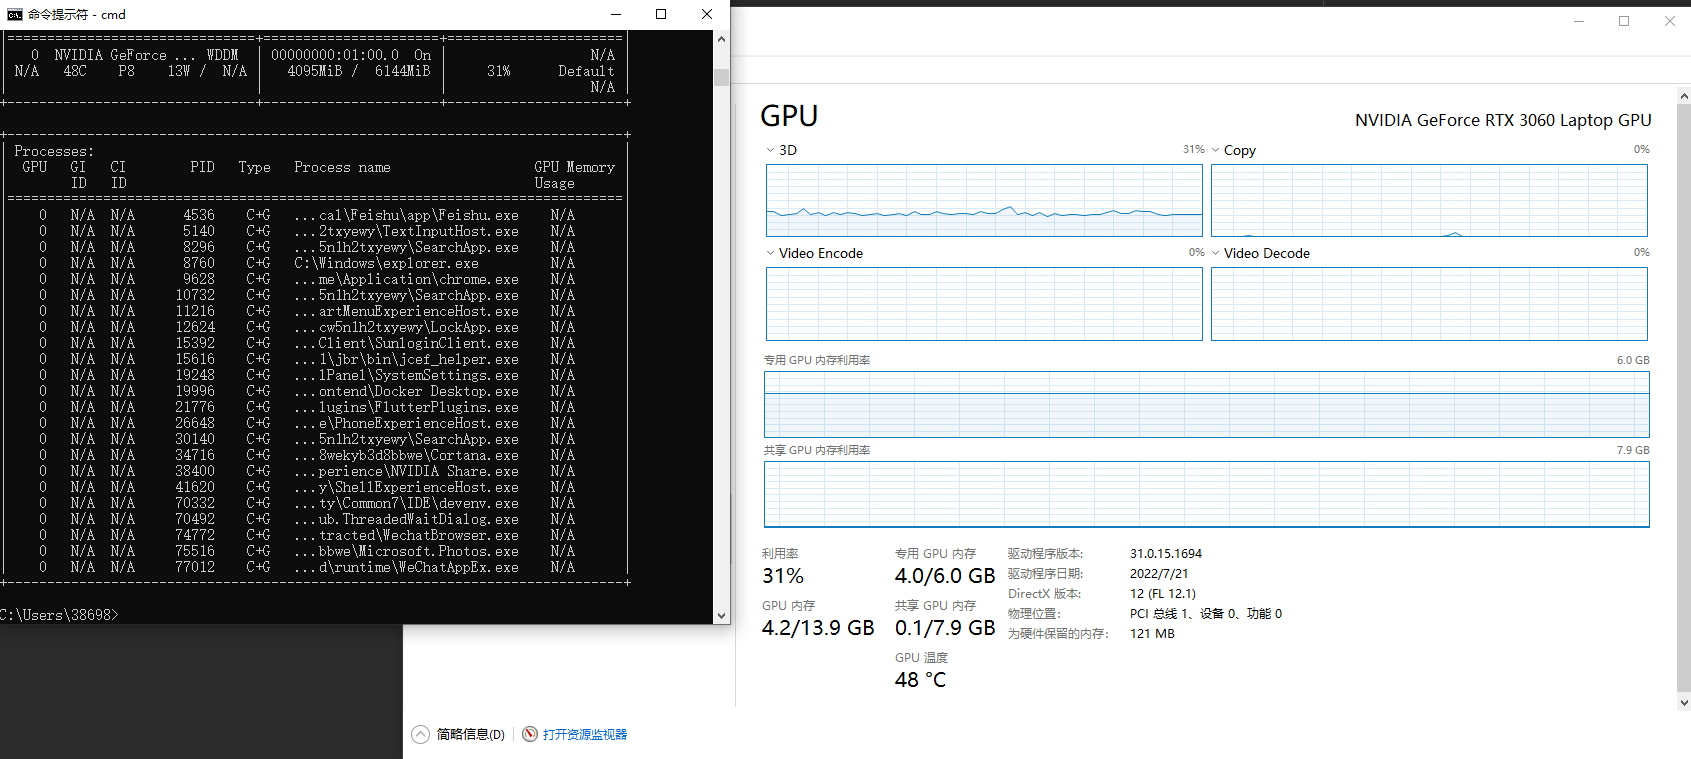
gpu 占用:
gpu 版 opencv 一帧比 cpu 版节约大概 1/3 的时间,还是有用的。
不过 nvidia-smi 里找不到对应的 python 进程;用任务管理器看,跑 gpu 版 opencv 时 gpu 利用率确实更高。可能 gpu 版 opencv 以一种我暂时无法理解的方式 work 了?不清楚原因,此处存疑。
本文由 aboom 原创,转载请注明出处。