预计阅读时间:11 分钟
yolov5 fp16 动态输入转 TensorRT 部署到 triton 服务
把 yolov5 训练出的 PyTorch 模型转换成 TensorRT 模型,扔进 triton 里部署。一条看似官方全程护航的流水线,实际每一步都有暗雷,本文按流程逐个排掉。
需求
- 为加快推理速度,把 fp32 精度的模型转成 fp16;
- 为支持 yolov5 动态 padding 和批推理,输入的 batch 和图片 size 需要是动态的。
版本
转换机(把 pt 转成 engine 的机器):
- yolov5:截图里的
export.py代码与 v6.2 写法一致(见下方 2026 年补注) - TensorRT:8.4.2.4
- cudnn:8.2.1.32
- CUDA Toolkit:11.3.1
部署机:triton docker 镜像 22.08(nvcr.io/nvidia/tritonserver:22.08-py3)。镜像内置 TensorRT 8.4.2.4,和转换机一致;镜像自带的 CUDA / cuDNN 版本与转换机不同,以 NVIDIA 框架支持矩阵的 22.08 列为准(2026-10-31 读取)。
2026 年补注:对照 ultralytics/yolov5 的官方源码,
--half与--dynamic互斥的断言、以及export_engine里按dynamic建 optimization profile 的分支,都是 v6.2(2022-08-17 发布)才有的,v6.1 的export.py里没有。本文截图里的代码与 v6.2 的写法一致(行号略有出入),复现时请用 v6.2(2026-10-31 读取 GitHub 上 v6.1 / v6.2 两个 tag 的export.py核对)。
流程
1. pt 转 onnx
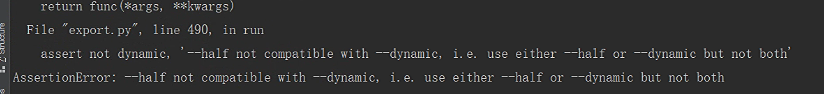
首先把 PyTorch 模型转成 onnx。yolov5 虽然自带转 engine 的方法,但这个版本(见上方补注)里 --dynamic(动态输入)和 --half(fp16)两个参数不兼容,一起用会报错:
AssertionError: --half not compatible with --dynamic, i.e. use either --half or --dynamic but not both
因此需要先单独转出 onnx,转换命令:
python export.py --weights last.pt --img 640 --dynamic --batch-size 1 --opset 13 --include onnx
--opset 13 要手动指定:export.py 的 --opset 默认是 12,而 yolov5 自己的 export_engine 在 TensorRT ≥ 8 时就是用 opset 13 导出 onnx 的(源码里是 export_onnx(model, im, file, 13, ...) # opset 13,opset 12 只给 TensorRT 7 用)。这里单独导出的 onnx 要接着喂给 TensorRT 8.4,所以和它保持一致用 13。
转完去 onnx 可视化看一眼产物:
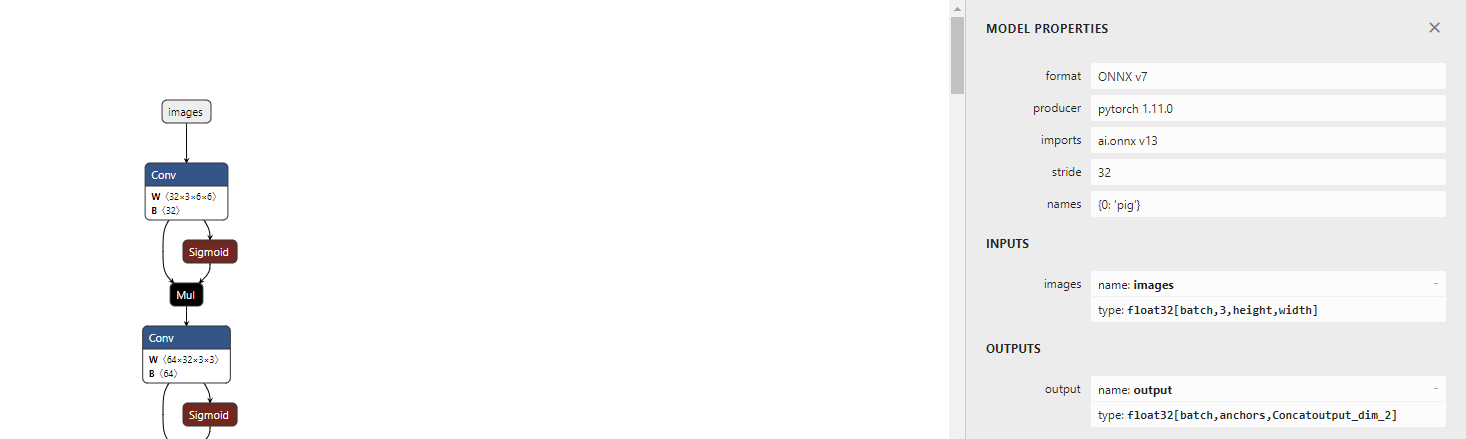
输入输出的 batch 和 size 都是动态的、不再是固定值,这一步没问题。
2. fp32 onnx 转 fp16 onnx
用 onnxmltools 转换:
import onnx
import onnxmltools
from onnxmltools.utils.float16_converter import convert_float_to_float16

# Input: the fp32 ONNX model exported in step 1
input_onnx_model = 'last.onnx'
# Output: deliberately the same file name, step 3 expects the fp16 model at last.onnx
output_onnx_model = 'last.onnx'
# Load the fp32 model
onnx_model = onnxmltools.utils.load_model(input_onnx_model)
# Convert float tensors to float16
onnx_model = convert_float_to_float16(onnx_model)
# Save as protobuf (overwrites the fp32 file)
onnxmltools.utils.save_model(onnx_model, output_onnx_model)
# Print the output tensors to check their dtype
model_onnx = onnx.load(output_onnx_model)
print(model_onnx.graph.output)
注意输入和输出是同一个文件名 last.onnx:这是故意覆盖,因为第 3 步要求 fp16 onnx 和 pt 模型同名放在一起。想保留 fp32 版本,先把 last.onnx 备份一份。
再可视化一次,新模型的输入输出变为 float16,即转换成功。这也意味着部署后模型的输入是 FP16,客户端发请求时要发 float16 数据。
3. onnx 转 TensorRT engine 模型
和第 1 步同样的问题:--dynamic 和 --half 不能同时用。对策是命令行只指定 --dynamic,--half 的部分进代码里改,一共改两处。
改动一:跳过 onnx 导出,强制半精度。在 yolov5 export.py 中找到 export_engine 函数,把原 pt 模型和转出来的 fp16 onnx 模型放到同一路径下(文件名需要相同,即 last.pt 和 last.onnx),注释掉 export_engine 里转 onnx 的部分(它会重新导出一份 fp32 onnx,覆盖掉第 2 步的成果),再在后面增加两行代码指定半精度转换。改完是这样(截图转写,左侧数字是截图里的行号):
# 233  # if trt.__version__[0] == '7':  # TensorRT 7 handling https://github.com/ultralytics/yolov5/issues/6012
# 234  #     grid = model.model[-1].anchor_grid
# 235  #     model.model[-1].anchor_grid = [a[..., :1, :1, :] for a in grid]
# 236  #     export_onnx(model, im, file, 12, False, dynamic, simplify)  # opset 12
# 237  #     model.model[-1].anchor_grid = grid
# 238  # else:  # TensorRT >= 8
# 239  #     check_version(trt.__version__, '8.0.0', hard=True)  # require tensorrt>=8.0.0
# 240  #     export_onnx(model, im, file, 13, False, dynamic, simplify)  # opset 13
half = True        # 241
im = im.half()     # 242
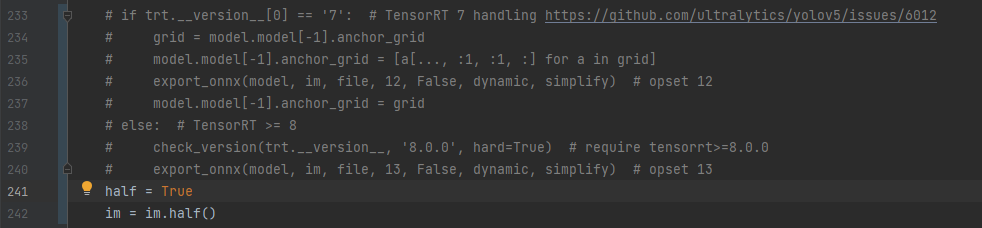
half = True 让后面 if builder.platform_has_fast_fp16 and half: 分支生效,给 builder 加上 trt.BuilderFlag.FP16。
改动二:改 optimization profile 的维度。在 export_engine 中找到 if dynamic: 的部分,把 profile.set_shape 的维度改成自己的值(截图转写,被注释掉的那行是 yolov5 原来的写法):
if dynamic:
    if im.shape[0] <= 1:
        LOGGER.warning(f"{prefix}WARNING: --dynamic model requires maximum --batch-size argument")
    profile = builder.create_optimization_profile()
    for inp in inputs:
        # input_name min opt max
        profile.set_shape(inp.name, (1, 3, 224, 224), (8, 3, 640, 640), (8, 3, 640, 640))
        # profile.set_shape(inp.name, (1, *im.shape[1:]), (max(1, im.shape[0] // 2), *im.shape[1:]), im.shape)
    config.add_optimization_profile(profile)
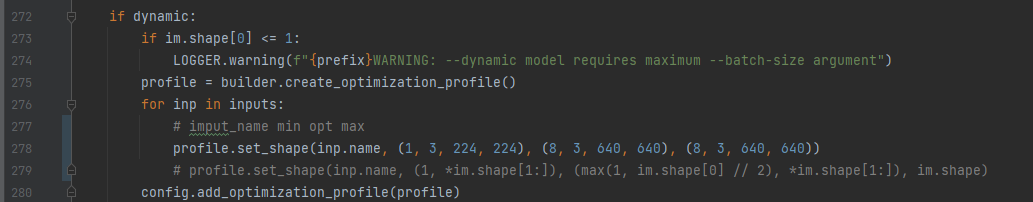
因为维度已经写死,命令行 --batch-size 1 触发的那条 WARNING 可以忽略。
set_shape 的四个参数分别是输入名、最小维度、最佳维度(opt)、最大维度:输入允许在最小与最大之间动态变化。最佳维度不是随便取的,TensorRT 的 auto-tuner 会针对它选择最快的实现(TensorRT 文档:optimization profile「also specify the dimensions for which the auto-tuner will optimize」,2026-10-31 读取),所以应该设成线上最常见的 batch 和图片尺寸。上面截图里 opt 和 max 写成一样,适合线上大多按满 batch、640 尺寸推理的情况。
如果改用 TensorRT 自带的 trtexec 工具转,对应的参数是 --minShapes --optShapes --maxShapes,详见 TensorRT 8.4 的 trtexec 官方说明(2026-10-31 读取),里面有示例 ./trtexec --onnx=model.onnx --minShapes=input:1x3x244x244 --optShapes=input:16x3x244x244 --maxShapes=input:32x3x244x244 --shapes=input:5x3x244x244。
转换命令:
python export.py --weights last.pt --img 640 --dynamic --batch-size 1 --include engine --device 0 --verbose
成功时,export_engine 会打印一行 TensorRT: export success, saved as last.engine (xx.x MB)(v6.2 源码里的 LOGGER.info),之后 export.py 还会再打印一段 Export complete 的汇总,所以它不是最后一行。如果 TensorRT 版本是 8.2,解析 onnx 时会在 Range 节点报错:
ERROR: builtin_op_importers.cpp:3352 In function importRange:
[8] Assertion failed: inputs.at(0).isInt32() && "For range operator with dynamic inputs, this version of TensorRT only supports INT32!"
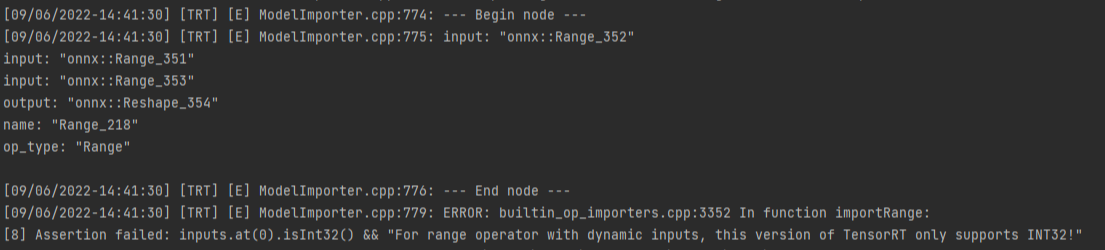
报错说的是:这个版本的 TensorRT 在 Range 算子输入是动态值时只支持 INT32。我当时把 TensorRT 升级到 8.4.2.4 后这个报错就消失了。
4. engine 模型部署到 triton
镜像要选 22.08——转换用的 TensorRT 版本必须和 triton docker 镜像内置的 TensorRT 版本一致,各镜像内置的软件版本见 triton 镜像版本对应关系。
把转出来的模型重命名为 model.plan,按 triton 要求的模型仓库结构放好(yolov5 是模型名,可以自己取;1 是版本号目录):
model_repository/
  yolov5/
    config.pbtxt      # optional for TensorRT models in 22.08, see below
    1/
      model.plan
启动 triton(命令来自 triton r22.08 的 quickstart 文档,2026-10-31 读取;/full/path/to/model_repository 换成上面目录的绝对路径):
docker run --gpus=1 --rm -p8000:8000 -p8001:8001 -p8002:8002 -v/full/path/to/model_repository:/models nvcr.io/nvidia/tritonserver:22.08-py3 tritonserver --model-repository=/models
8000、8001、8002 分别是 HTTP、GRPC 和监控指标端口。
关于 config.pbtxt:按 r22.08 的模型配置文档(2026-10-31 读取),triton 默认会为大多数 TensorRT 模型自动补全最小配置(platform、max_batch_size、输入输出),所以不写 config.pbtxt 也能加载;用 --disable-auto-complete-config 启动才会关掉自动补全。服务起来后用下面的命令查看 triton 实际使用的模型配置(yolov5 换成自己的模型名,8000 是 HTTP 端口):
curl localhost:8000/v2/models/yolov5/config
需要固定配置时,文档建议把这份 JSON 里的 max_batch_size、input、output 抄成 config.pbtxt。
关于 batch 维度:如果在 config.pbtxt 里指定了 max_batch_size(大于 0),batch 在 triton 中是隐式的,不会显式出现在输入输出维度里,input 和 output 的动态维度用 -1 表示、不带 batch 维;如果 max_batch_size 设为 0(不让 triton 管 batch),则输入输出最前面需要自己用 -1 指定动态 batch 维度。
5. 其他问题
转换用的显卡和部署用的显卡算力(compute capability)必须相同,不能只看是不是同一「系列」。在 30 系显卡上转换、拿到 20 系显卡上部署,会报算力不匹配的错误——20 系是 compute 7.5,30 系是 compute 8.6。各型号的算力查 英伟达算力表。
本文由 aboom 原创,转载请注明出处。